Matz の Spinel を試してみてワクワクが止まらない!
最近、まつもとゆきひろさんが開発されている Spinel を Mac と Linux 機それぞれで試してみました。
RubyKaigi 2026 に参加後少し間が空いてからではあったのですが、実際に試して体験したこと・RubyKaigi 2026 時からの Spinel の進化にすごくワクワクしました!
簡単ではありますが、自分が Spinel について調べたことと試したことをまとめておきたいと思います。
まずは試してみる
SpinelはRubyのコードからネイティブ実行ファイルを生成するコンパイラです。ただ、正直自分の場合は README の説明を読んだだけではあまり具体的なイメージを持つことができなかったため、まずは実際に動かして試してみることにしました。
Spinel のビルドは数ステップでとても簡単で、Mac でも Linux(Gentoo) でも特にエラーにはならずにビルドをすることができました。
git clone https://github.com/matz/spinel.git
cd spinel
make deps
make
最初に試したのは README に記載があるフィボナッチ数列です。
# fib.rb

def fib(n)
  if n < 2
    n
  else
    fib(n - 1) + fib(n - 2)
  end
end

puts fib(34)
これを Spinel に渡します。
$ ./spinel fib.rb
すると fib という実行ファイルが生成されます。
実行してみると、
$ ./fib
5702887
結果を得ることができました!
また、元々が Ruby スクリプトなので、
$ ruby fib.rb
5702887
としても実行できます。 「Ruby をコンパイルする」ということのイメージがなんとなく湧いてきました。
本当に実行ファイルになっている
上で確認したように Spinel で作られた実行ファイルでも元の .rb ファイルでも同じ結果を得られた訳ですが、ファイルの形式が違うんだということを実感するために file コマンドで結果を確認してみました。
Rubyスクリプトの場合は当たり前?かもですが、このように表示されます。
$ file fib.rb
fib.rb: Ruby script text, ASCII text
Mac での結果ですが Spinel が生成したファイルはこのようになっています。
$ file fib
fib: Mach-O 64-bit executable arm64
Spinel が生成したファイルは Ruby スクリプトではなく、OS が直接実行できる形式になっています。
依存ライブラリも確認してみる
続いて Mac の otool コマンドや Linux の ldd コマンドを使って依存ライブラリを確認したいと思います。
Spinel によって生成された実行ファイルは、
Mac の場合
$ otool -L ./fib
./fib:
        /usr/lib/libSystem.B.dylib (compatibility version 1.0.0, current version 1356.0.0)
Linux の場合
ldd ./fib
    linux-vdso.so.1 (0x00007ff996b51000)
    libm.so.6 => /usr/lib64/libm.so.6 (0x00007ff996a4a000)
    libc.so.6 => /usr/lib64/libc.so.6 (0x00007ff996878000)
    /lib64/ld-linux-x86-64.so.2 (0x00007ff996b53000)
という結果でした。 (本題とはずれますが、Mac と Linux の結果の違いも個人的には興味深かったです)
通常の Ruby は、
Mac の場合
$ otool -L $(which ruby)
/Users/xxx/.local/share/mise/installs/ruby/4.0.5/bin/ruby:
        /System/Library/Frameworks/CoreFoundation.framework/Versions/A/CoreFoundation (compatibility version 150.0.0, current version 4201.0.0)
        /Users/xxx/.local/share/mise/installs/ruby/4.0.5/lib/libruby.4.0.dylib (compatibility version 4.0.0, current version 4.0.5)
        /opt/homebrew/opt/gmp/lib/libgmp.10.dylib (compatibility version 16.0.0, current version 16.0.0)
        /usr/lib/libSystem.B.dylib (compatibility version 1.0.0, current version 1356.0.0)
        /usr/lib/libobjc.A.dylib (compatibility version 1.0.0, current version 228.0.0)
Linux の場合
$ ldd $(which ruby)
    linux-vdso.so.1 (0x00007f1500db9000)
    libruby.so.4.0 => /home/xxx/.local/share/mise/installs/ruby/4.0.5/lib/libruby.so.4.0 (0x00007f1500400000)
    libz.so.1 => /usr/lib64/libz.so.1 (0x00007f1500d74000)
    libgmp.so.10 => /usr/lib64/libgmp.so.10 (0x00007f1500ccb000)
    libcrypt.so.2 => /usr/lib64/libcrypt.so.2 (0x00007f15003c6000)
    libm.so.6 => /usr/lib64/libm.so.6 (0x00007f15002ec000)
    libc.so.6 => /usr/lib64/libc.so.6 (0x00007f150011a000)
    libgcc_s.so.1 => /usr/lib/gcc/x86_64-pc-linux-gnu/16/libgcc_s.so.1 (0x00007f1500c9b000)
    /lib64/ld-linux-x86-64.so.2 (0x00007f1500dbb000)
など複数のライブラリに依存しています。
ここまで確認して Spinel が生成する実行ファイルは libruby などの Ruby ランタイムには依存しないスタンドアロンな実行ファイルになっているんだということを改めて実感しました。
ここでようやく Spinel とは?
README には次のように書かれています。
SpinelはRubyのソースコードをスタンドアローンのネイティブ実行形式にコンパイルするツールです。プログラム全体を対象とした型推論を行い、最適化されたCコードを生成することで、CRubyと比較して大幅な高速化を実現します。
ざっくりまとめると、
- Ruby コードを解析する
- プログラム全体の型を推論する
- 最適化された C コードを生成する
- C コンパイラでネイティブ実行ファイルを作る
という流れになっています。
README には次のような図があります。
Ruby (.rb)
    |
    v
parse (libprism)       Parse with Prism, linked in as a C library
    |                  (a CRuby + Prism-gem path produces the same AST)
    v
text AST -> NodeTable  Loaded into an in-memory node table
    |
    v
analyze                Whole-program type inference (src/analyze*.c).
    |                  Walks the AST to a fixpoint: param / return / ivar
    |                  types, value-type detection, dead-code markers,
    |                  a per-node inferred-type cache.
    v
codegen                C code generation (src/codegen*.c). Reads the AST
    |                  plus the analysis just computed in the same process,
    |                  emits one C file.
    v
C source (.c)
    |
    v
cc -O2 -Ilib -lm      System C compiler + runtime
    |
    v
Native binary           Standalone, no runtime dependencies
Spinel 自身が直接ネイティブコードを生成するのではなく、一度Cコードを生成し、その後システムのCコンパイラに処理を委ねています。
AOT コンパイラとは?
Spinel は AOT(Ahead-Of-Time)コンパイラと呼ばれるものです。
AOT とは「実行前にまとめてコンパイルする」方式です。
一方で RubyKaigi などでよく耳にする JIT (Just-In-Time) は、プログラムを実行しながらホットな部分だけをコンパイルします。
大きな違いは、「いつコンパイルするか」です。
型推論とは?
Rubyは動的型付け言語なので、コードを書く際に型を宣言しませんが Spinel はプログラム全体を解析して、
- この変数は Integer
- このメソッドは Stringを返す
- このインスタンス変数は Array
のような情報を推論します。
READMEでは Whole-program Type Inference と説明されています。
プログラム全体を解析して型を推論することで、高速なCコードを生成できるようになります。逆に言えば、現時点では Ruby のすべての機能を対象としているわけではありません。この点は RubyKaigi 2026 でも言及されていたのと README にも現在サポートしていない機能や制約がまとめられています。
セルフホスティングから C 実装へ
2026-07-02 追記
こちらの記事を公開後、まつもとゆきひろさんからコメントをいただき、最新の Spinel からはこの後触れている legacy ディレクトリは削除されているそうです。
ちょうどこの記事が書かれたタイミングでlegacyディレクトリを削除しちゃいました。bootstrapできるRuby版はself-hostブランチに残ってます。
— Yukihiro Matz (@yukihiro_matz) 2026年7月1日
個人的に一番興味深かったのがここです。
現在のコンパイラ本体のコード生成部分は C で実装されていますが、RubyKaigi 2026 で発表された当時は Ruby で書かれていました。
Ruby での実装は現在も legacy ディレクトリとしてリポジトリに残っています。
SpinelをCで実装し直した。今回は丸々1週間かかった。セルフホストはコンパイラ書きにとってロマンだけど、8万行まで育ったコンパイラに全体型解析をかけるとビルドに20分くらいかかるので生産性が落ちてしまっていたので。
— Yukihiro Matz (@yukihiro_matz) 2026年6月15日
C 実装への移行は比較的最近行われたようです。
ちなみに Ruby 実装の Spinel も現在試すことは可能です。
make bootstrap を実行すると、
- Ruby 版 Spinelで最初のコンパイラを作る
- 生成したコンパイラでもう一度自分自身をコンパイルする
- 2回目と3回目の出力が一致することを確認する
という一連の流れを見ることができます。 大量のログが流れますが、「コンパイラ自身をコンパイルしている」という様子がログの内容から分かってすごく面白かったのと、コンパイラ自身をRubyで実装していたという点がとにかく興味深くてもっとこのあたりの仕組みについても分かるようになりたいと思ったりしました。
また、現在は C 実装に置き換わっていますが、こうした変遷を知る面白さも同時に感じました。
おわりに
Spinel を試してみて「Ruby ファイルが実行ファイルになる」という体験が一番印象的でした。
ここまで書いてきたようにファイル形式や依存ライブラリの違いなども確認しつつ実際に試してみると Spinel についてより身近に感じることができるようになりました。 また、Spinel を通じて「コンパイラってこんなことをしているんだ」ということも知ることができ、よりワクワクしながら試すことができました。
実は Spinel を試す中で Mac だとコンパイルが通るけれど、Gentoo だとコンパイルが通らないコードがあり、自分でも原因を調べていたら数日後には問題が解消していてどちらの環境でもコンパイルが通るようになっていました。Spinel は日々改善・開発されて進化していっているんだと実感してさらにワクワクした瞬間でもあります。 Spinel を試したことで、Spinel 自身もコンパイラや実行環境の違いなど関連して自分がもっと知りたい!と思う部分が以前よりもちょっと明確になり、プログラミングは楽しいな!やめられない!と再認識しています。
今回の記事がまだ Spinel を試したことがない方にとってなんらかの参考になれば嬉しいです。
しんめ.rb は 2026年7月で定期開催を終了します
2年ほど開催を続けてきたしんめ.rb ですが、私がエンジニアにキャリアチェンジして丸3年を迎える2026年7月をもって、定期開催を終了することにしました。 RubyKaigi ハイ?で周囲にはこれからも続けます!という話をしたりしていたのですが、少し時間が経って落ち着いてきたところで考えを整理して、そろそろ「しんめ」を名乗る時期は卒業かなぁと薄々感じていたこともあって、一区切りをつけることにしました。
約2年の間にたくさんの方に参加いただき、現時点で通算66回開催をすることができました。自分が一人で運営していたコミュニティだったため、準備不足だったり自分の理解不足だったりでうまく進行できなかった回もあったりしました。ただ、毎回雑談の時間だったり勉強テーマについての質問を通じてだったり、しんめ.rb をやっていたからこその楽しい会話や気づきがありました。そして、仕事や自分が行ける範囲のオフラインのイベントやカンファレンスのみでは知り合うことができなかったであろう Rubyist のみなさんと出会えたことが何よりも自分でコミュニティを主催してよかったことです。
残り2か月ほどありますが、6月と7月は各1回ずつミートアップを開催しようと思っています。
- 6月22日(月)19時半〜21時※時間が違うのでお気をつけください!
- 7月27日(月)21時〜22時半
6月はまつもとゆきひろさんが開発されている Splinel を知る回、7月は座談会をやろうと考えています。
ご都合が合う方はぜひご参加いただけると嬉しいです!
しんめ.rb としてはコミュニティの開催に区切りをつけますが、私はみんなでワイワイしながらプログラミングしたり技術について雑談するのがやっぱり好きなので、形を変えて?なにかできたらいいなという思いはありつつ、今年は最近参加できていない他のコミュニティや地域 Ruby 会議に参加していこうと思っています。
これまでしんめ.rb に関わってくれた方々に感謝を込めて。 2年間ありがとうございました!!
Require Hooks に興味津々
RubyKaigi 2026 で palkan さんが発表されていた Require Hooks が自分の中ですごく印象的でした。
Ruby には現在 require を拡張するための機能が存在しないため、require の瞬間に何かしたいみたいな場合に、monkey patch で実装依存になってしまいます。 この課題に対して Require Hooks が require 拡張ポイントを提供することで共通のしくみとして使えるようにしたという発表内容でした。
require を拡張するしくみを Ruby のレイヤーから実現しているという点も、そういうアプローチができるのか!と強く印象に残った理由の一つになっています。
というわけで、Require Hooks に興味津々なため実際に Rails アプリに入れて試したことを簡単にまとめてみます。
準備
こちらの記事で触れた自分用の Rails アプリで試してみました。
まず、README にある通りに導入準備をします。
# Gemfile
gem 'require-hooks'
bundle install を実行して、config/ 以下にファイルを作成します。
# config/require_hooks.rb

require 'require-hooks/setup'
作成したファイルを application.rb で読み込みます。
# config/application.rb


require_relative 'boot'

require 'rails/all'

Bundler.require(*Rails.groups)

require_relative 'require_hooks' # 追記
直接 application.rb で require 'require-hooks/setup' を追加しても良かったのですが、検証用にコードを追加したりするため、分かりやすいように分けました。
Require Hooks には3種類のフックがあります。
| フック | 内容 |
|---|---|
| around_load | ファイルのロード前後に処理を挟む |
| source_transform | ソースコードを書き換えてからロードする |
| hijack_load | ISeq(命令列)を自分でコンパイルして渡す |
これをそれぞれ試していきたいと思います。
around_load
まずは around_load から。
app/ 以下のファイルがロードされるタイミングでログにパスを出力するようにします。
先ほど作成した require_hooks.rb に以下を追記します。
app_pattern = File.expand_path("../app/**/*.rb", __dir__)


RequireHooks.around_load(patterns: [app_pattern]) do |path, &block|
  puts "[require-hooks] Loading: #{path}"
  result = block.call
  puts "[require-hooks] Loaded:  #{path}"
  result
end
変更を保存してサーバーを起動して localhost:3000 にアクセスすると以下の出力が得られます。
[require-hooks] Loading: .../app/controllers/homes_controller.rb
[require-hooks] Loading: .../app/controllers/application_controller.rb
[require-hooks] Loading: .../app/helpers/application_helper.rb
[require-hooks] Loaded:  .../app/helpers/application_helper.rb
[require-hooks] Loading: .../app/controllers/concerns/authentication.rb
[require-hooks] Loaded:  .../app/controllers/concerns/authentication.rb
[require-hooks] Loaded:  .../app/controllers/application_controller.rb
[require-hooks] Loaded:  .../app/controllers/homes_controller.rb

Processing by HomesController#show as HTML

[require-hooks] Loading: .../app/models/current.rb
[require-hooks] Loaded: .../app/models/current.rb
[require-hooks] Loading: .../app/models/session.rb
[require-hooks] Loading: .../app/models/application_record.rb
[require-hooks] Loaded:  .../app/models/application_record.rb
[require-hooks] Loaded:  .../app/models/session.rb
  Session Load (0.1ms)  SELECT "sessions".* FROM "sessions" WHERE "sessions"."id" = 2 LIMIT 1 /*action='show',application='Yondayo',controller='homes'*/
  ↳ app/controllers/concerns/authentication.rb:29:in 'Authentication#find_session_by_cookie'
[require-hooks] Loading: .../app/models/user.rb
[require-hooks] Loaded:  .../app/models/user.rb
  User Load (0.0ms)  SELECT "users".* FROM "users" WHERE "users"."id" = 1 LIMIT 1 /*action='show',application='Yondayo',controller='homes'*/
  ↳ app/models/current.rb:3:in 'Current#user'
[require-hooks] Loading: .../app/models/reading.rb
[require-hooks] Loaded:  .../app/models/reading.rb
development 環境で最初のリクエスト時に Zeitwerk によってオートロードされた app/ 以下のファイルが確認できます。
ここで面白かったのはログのフェーズが2段階に分かれていることで、Processing by HomesController#show as HTML
を境に異なるファイルがロードされていることが分かります。
HomesController#show アクションの実行前は homes_controller.rb のロード中に application_controller.rb がロードされ、さらにその中で application_helper.rb → authentication.rb と連鎖しています。
アクション実行中は current.rb ロード実行と完了、session.rb のロード中に application_record.rb を内部でロードして session.rb ロード完了、user.rb と reading.rb のロード実行とロード完了という流れが読み取れます。
パスをログに出すことができたのでファイルのロード時間をログに出力してみます。
先程のコードを以下のように修正します。
RequireHooks.around_load(patterns: [app_pattern]) do |path, &block|
  start = Process.clock_gettime(Process::CLOCK_MONOTONIC)
  result = block.call
  elapsed = Process.clock_gettime(Process::CLOCK_MONOTONIC) - start
  Rails.logger.debug format("[require-hooks] %.4fs %s", elapsed, path)
  result
end
サーバーを再起動してブラウザのページをリロードします。
[require-hooks] 0.0006s .../app/helpers/application_helper.rb
[require-hooks] 0.0002s .../app/controllers/concerns/authentication.rb
[require-hooks] 0.0017s .../app/controllers/application_controller.rb
[require-hooks] 0.0022s .../app/controllers/homes_controller.rb
Processing by HomesController#show as HTML
[require-hooks] 0.0008s /.../app/models/current.rb
[require-hooks] 0.0033s ...app/models/application_record.rb
[require-hooks] 0.0047s .../app/models/session.rb
  Session Load (0.1ms)  SELECT "sessions".* FROM "sessions" WHERE "sessions"."id" = 2 LIMIT 1 /*action='show',application='Yondayo',controller='homes'*/
  ↳ app/controllers/concerns/authentication.rb:29:in 'Authentication#find_session_by_cookie'
[require-hooks] 0.0076s .../app/models/user.rb
  User Load (0.0ms)  SELECT "users".* FROM "users" WHERE "users"."id" = 1 LIMIT 1 /*action='show',application='Yondayo',controller='homes'*/
  ↳ app/models/current.rb:3:in 'Current#user'
[require-hooks] 0.0010s .../app/models/reading.rb
ファイルのパスをログに出力した際にあるファイルをロード中に別のファイルがロードされていたと思いますが、この計測時間はそのネストしたロードを含む累積時間を指しています。 そのため、session.rb 自体のコードの評価にかかった時間は application_record.rb の時間を差し引いた 0.0047 - 0.0033 = 0.0014s ほどということが分かります。
user.rb はネストしていないため、単体ファイルとして一番ロードに時間がかかったファイルということが読み取れます。関連やバリデーションの定義が多いからかな。
ここまでで around_load でできることのイメージが具体的になったのではないでしょうか?試したことはシンプルですが、ロードのタイミングを可視化できて面白かったです。
source_transform
次は source_transform です。
RubyKaigi 2026 の発表でも触れられていた frozen_string_literal を自動挿入してみようと思います。
モデルに定数を定義して source_transform を使用する前後の結果を比較してみます。
# app/models/reading.rb

class Reading < ApplicationRecord
  TEST_STR = "hello"
end
rails console で Reading::TEST_STR.frozen? の結果を確認します。
> Reading::TEST_STR.frozen?
=> false
続いて、require_hooks.rbを以下のように修正してみます。
RequireHooks.source_transform(
  patterns: [app_pattern],
  exclude_patterns: [File.expand_path("../app/views/**/*", __dir__)]
) do |path, source|
  source ||= File.read(path)
  next source if source.start_with?("# frozen_string_literal: true")

  "# frozen_string_literal: true\n#{source}"
end
もう一度 rails console を起動して結果を確認すると
> Reading::TEST_STR.frozen?
=> true
true になりました!!
別の使い方として、test.book というファイルに本の名前を列挙して保存しておき、それを source_transform を使って Ruby コードに変換することを試してみようと思います。
# test.book
BOOK1
BOOK2
BOOK3
require_hooks.rb を以下のように修正します。
book_pattern = File.expand_path("../*.book", __dir__)

RequireHooks.source_transform(patterns: [book_pattern]) do |path, source|
  source ||= File.read(path)
  books = source.lines.map(&:chomp).reject(&:empty?)
  class_name = File.basename(path, ".book").capitalize
  books_literal = books.map { |b| "    \"#{b}\"" }.join(",\n")
  ruby_code = <<~RUBY
    class #{class_name}
      BOOKS = [
    #{books_literal}
      ]
    end
  RUBY
  ruby_code
end

load File.expand_path("../test.book", __dir__)
source_transform はロードのタイミングで発火するフックのため、変換処理を登録するだけでは駄目で load で実際にファイルを読み込む必要があります。
検証用のコードとして一時的に置いています。
保存して rails console で Test::BOOKS の結果を見てみます。
> Test::BOOKS
=> ["BOOK1", "BOOK2", "BOOK3"]
test.book ファイルの内容が BOOKS という定数に配列として格納されています!
ここで面白いのは test.book は Ruby として無効なファイルなのに load ができることです。
RequireHooks.source_transform のブロックを消して load の行だけ残して rails console を起動しようとするとエラーになります。
uninitialized constant BOOK1 (NameError)

BOOK1
^^^^^
source_transform が test.book が Ruby コードとして評価される前にソースを差し替えていることが分かる例で、ロードの前後にフックする around_load との違いも理解できます。
hijack_load
最後は hijack_load です。
hijack_load は MRI や JRuby などの実装に応じてコンパイル方法を切り替えることで、たとえば require-hooks の README では以下ような使い方が書かれています。
# Pattern can be a Proc. If it returns `true`, the hijacker is used.
RequireHooks.hijack_load(patterns: ["/my_project/*.rb"]) do |path, source|
  source ||= File.read(path)
  if defined?(RubyVM::InstructionSequence)
    RubyVM::InstructionSequence.compile(source)
  elsif defined?(JRUBY_VERSION)
    JRuby.compile(source)
  end
end
今回は学習用に ISeq を取得してみることを試しました。
require_hooks.rb を修正します。
RequireHooks.hijack_load(patterns: [app_pattern]) do |path, source|
  source ||= File.read(path)
  iseq = RubyVM::InstructionSequence.compile(source, path, path, 1)
  puts "[hijack] Compiled #{File.basename(path)} → #{iseq.inspect}"
  iseq
end
サーバーを再起動してブラウザのページをリロードします。
[hijack] Compiled homes_controller.rb → <RubyVM::InstructionSequence:<compiled>@.../app/controllers/homes_controller.rb:1>
[hijack] Compiled application_controller.rb → <RubyVM::InstructionSequence:<compiled>@.../app/controllers/application_controller.rb:1>
[hijack] Compiled application_helper.rb → <RubyVM::InstructionSequence:<compiled>@.../app/helpers/application_helper.rb:1>
[hijack] Compiled authentication.rb → <RubyVM::InstructionSequence:<compiled>@.../app/controllers/concerns/authentication.rb:1>
Processing by HomesController#show as HTML
[hijack] Compiled current.rb → <RubyVM::InstructionSequence:<compiled>@.../app/models/current.rb:1>
[hijack] Compiled session.rb → <RubyVM::InstructionSequence:<compiled>@.../app/models/session.rb:1>
[hijack] Compiled application_record.rb → <RubyVM::InstructionSequence:<compiled>@.../app/models/application_record.rb:1>
ISeq を取得してログに出せたわけですが、正直よくわからない・・・。 Claude に質問してみたところ、逆アセンブルしてみると面白いかもしれないとのことで試してみました。
require_hooks.rb を少し修正します。
RequireHooks.hijack_load(patterns: [app_pattern]) do |path, source|
  source ||= File.read(path)
  iseq = RubyVM::InstructionSequence.compile(source, path, path, 1)
  puts iseq.disasm if File.basename(path) == "book.rb"
  iseq
end
もう一度サーバーを再起動すると、逆アセンブルした結果をログに出力できました!
== disasm: #<ISeq:<compiled>@.../app/models/book.rb:1 (1,0)-(5,3)>
0000 putspecialobject                       3                         (   1)[Li]
0002 opt_getconstant_path                   <ic:0 ApplicationRecord>
0004 defineclass                            :Book, <class:Book>, 16
0008 leave

== disasm: #<ISeq:<class:Book>@.../app/models/book.rb:1 (1,0)-(5,3)>
0000 putself                                                          (   2)[LiCl]
0001 putobject                              :readings
0003 putobject                              :destroy
0005 opt_send_without_block                 <calldata!mid:has_many, argc:2, kw:[dependent], FCALL|KWARG>
0007 pop
0008 putself                                                          (   4)[Li]
0009 putobject                              :title
0011 putobject                              true
0013 opt_send_without_block                 <calldata!mid:validates, argc:2, kw:[presence], FCALL|KWARG>
0015 leave                                                            (   5)[En]
内容は全然わからないため、Claude に解説してもらいました。
== disasm: #<ISeq:<compiled>@<compiled>:2 (2,0)-(6,3)>
0000 putspecialobject  3                  # クラス定義に必要な特殊オブジェクトをスタックに積む
0002 opt_getconstant_path  <ic:0 ApplicationRecord>  # ApplicationRecord 定数を取得
0004 defineclass  :Book, <class:Book>, 16  # Book クラスを定義(内側の ISeq を使う)
0008 leave                                 # 終了
== disasm: #<ISeq:<class:Book>@<compiled>:2 (2,0)-(6,3)>
0000 putself                              # self(Book クラス)をスタックに積む
0001 putobject  :readings                 # :readings をスタックに積む
0003 putobject  :destroy                  # :destroy をスタックに積む
0005 opt_send_without_block  has_many, argc:2, kw:[dependent]  # has_many :readings, dependent: :destroy を呼ぶ
0007 pop                                  # 戻り値を捨てる
0008 putself                              # self をスタックに積む
0009 putobject  :title                    # :title をスタックに積む
0011 putobject  true                      # true をスタックに積む
0013 opt_send_without_block  validates, argc:2, kw:[presence]  # validates :title, presence: true を呼ぶ
0015 leave                                # 終了
ちなみに app/models/book.rb の内容はこうなっています。
class Book < ApplicationRecord
  has_many :readings, dependent: :destroy
  validates :title, presence: true
end
本来の用途ではないですが、hijack_load で ISeq を逆アセンブルすると ISeq の命令列を見ることができるため、JIT の基礎を知ることに繋がったりするかな?と思ったりしました。
まとめ
Require Hooks の3つのフックについてそれぞれ試して何ができるのかを整理してみました。 試しながら結果を調べる過程で私はだいぶワクワク楽しく過ごせました。
もう少し実践的に活用できるシーンも考えてみたいと思います。
車輪の再発明だけど、最近よく使っている自作アプリ
RubyKaigi 2026に参加してまつもとゆきひろさんのキーノートを聞いた影響で、私もいろいろ作るぞという気持ちが高まっている。
一方で最近、自分の中でアウトプットのハードルがどんどん上がってしまっていて、全くブログを書いたりできていなかった。今日はアウトプットのハードルを下げるために、最近作った車輪の再発明だけどよく使っている読書記録アプリについて書いておこうと思う。
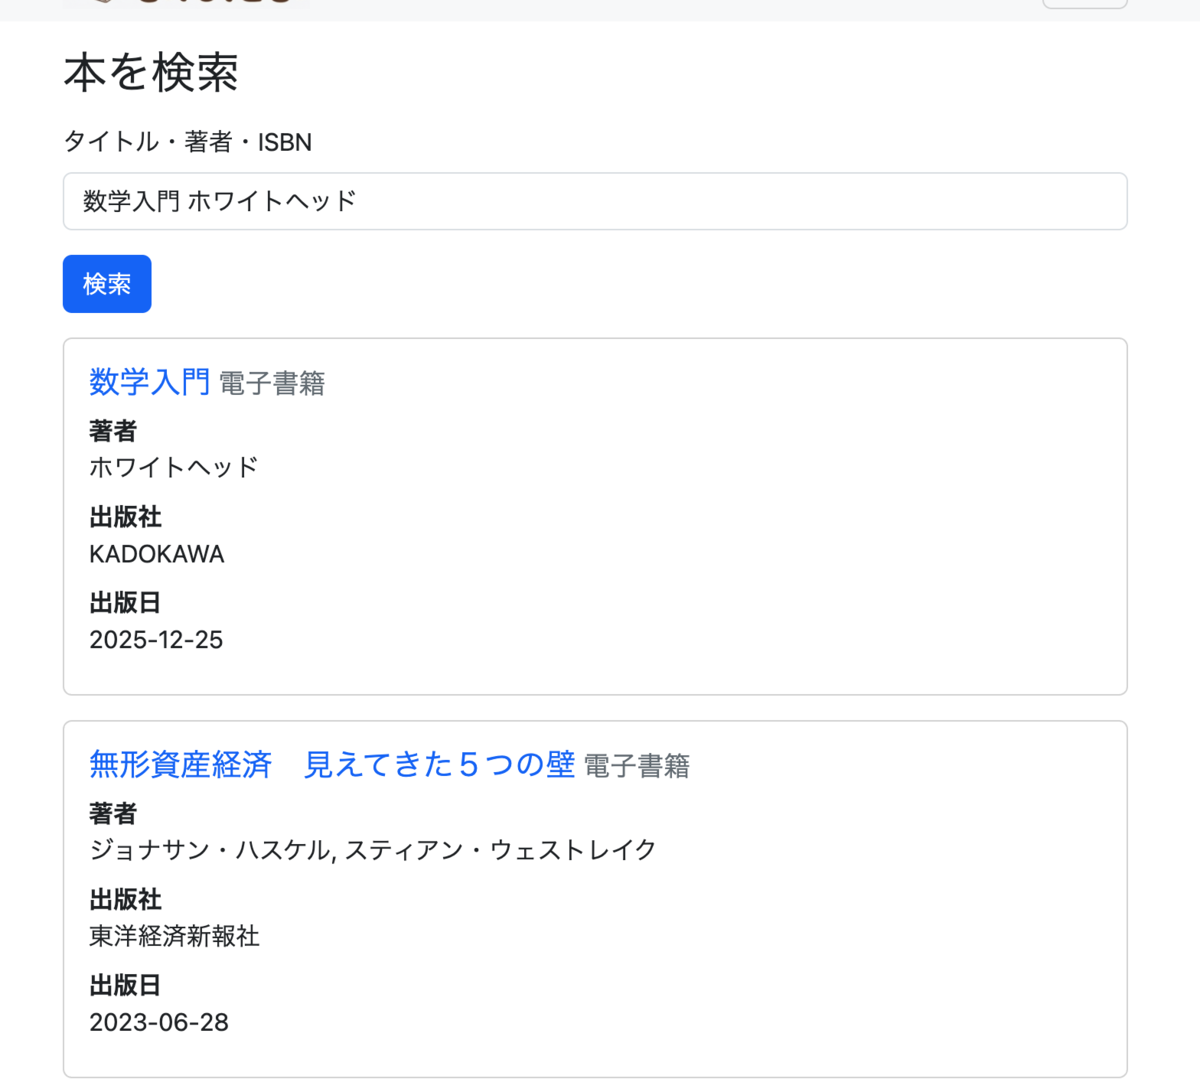
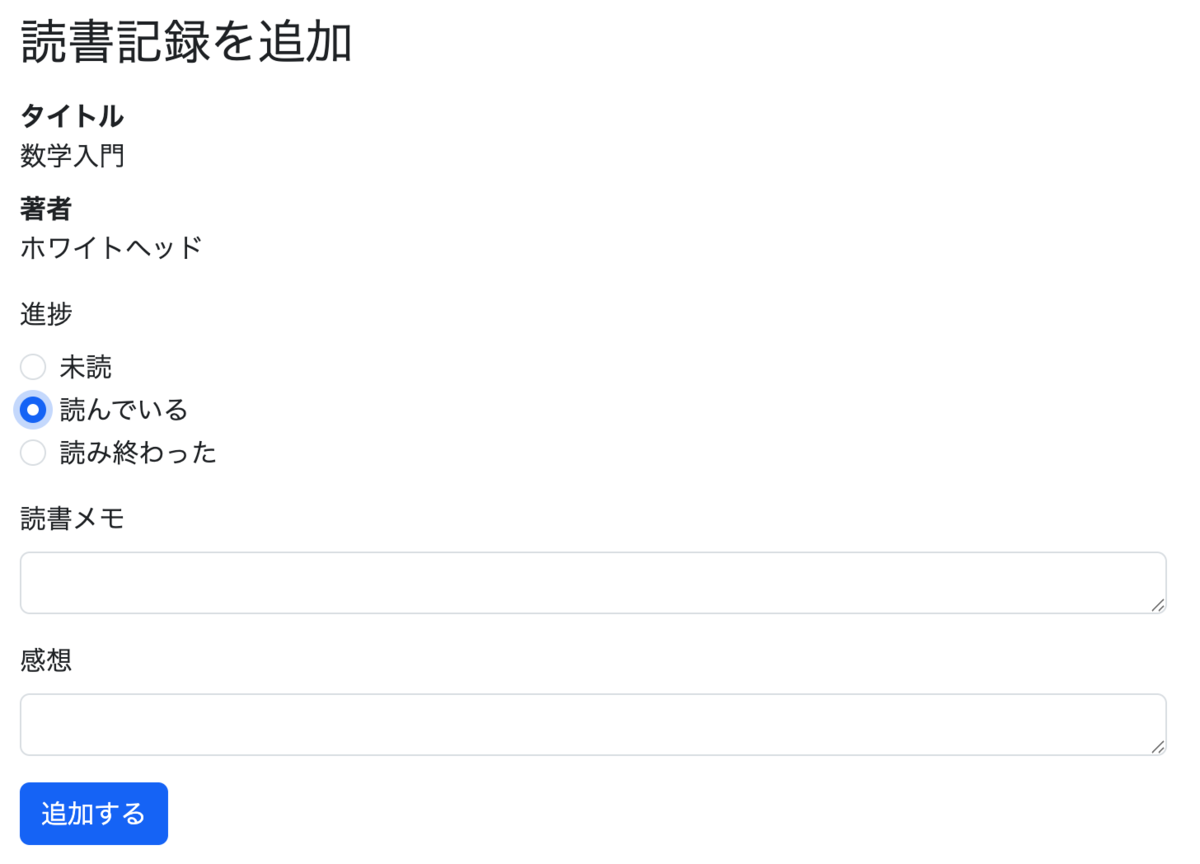
私は読書が好きで、いろいろな本を読むため「よんだよ」という自分が読んだ本を記録しておくためのWebアプリを作った。基本的には自分が使うためを想定していて、ログインしないと内容は見れないようになっている。 できることは、Google Books API で書籍を検索して読んでいる本を選択し、読書の進捗状況、読書中のメモ、読み終わった後の感想を記録できるようになっている。 作っている途中で元々自分が使っていた別の読書記録アプリがSNSで読書記録をシェアするときにOGPが表示されないことに気がついて、自分が作っているアプリの方でOGPありでシェアできたらいいなぁと思って公開用のリンクを別途取得できるようにした。
本の検索は、タイトル・著者・ISBN でできるようにしてある。
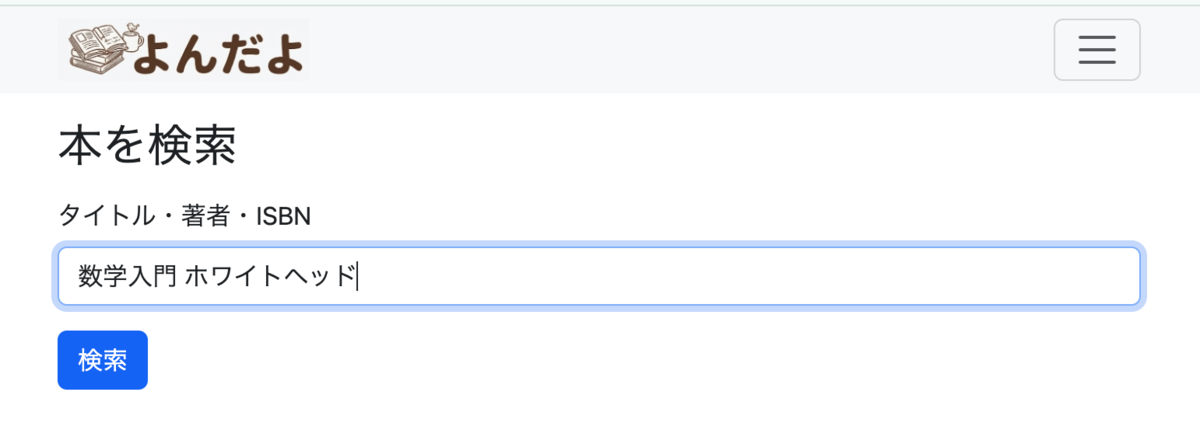
結果は複数ヒットするため、該当の本を選択する。
メモを取りつつ読み進めて読み終わったら感想を入れて更新して使っている。
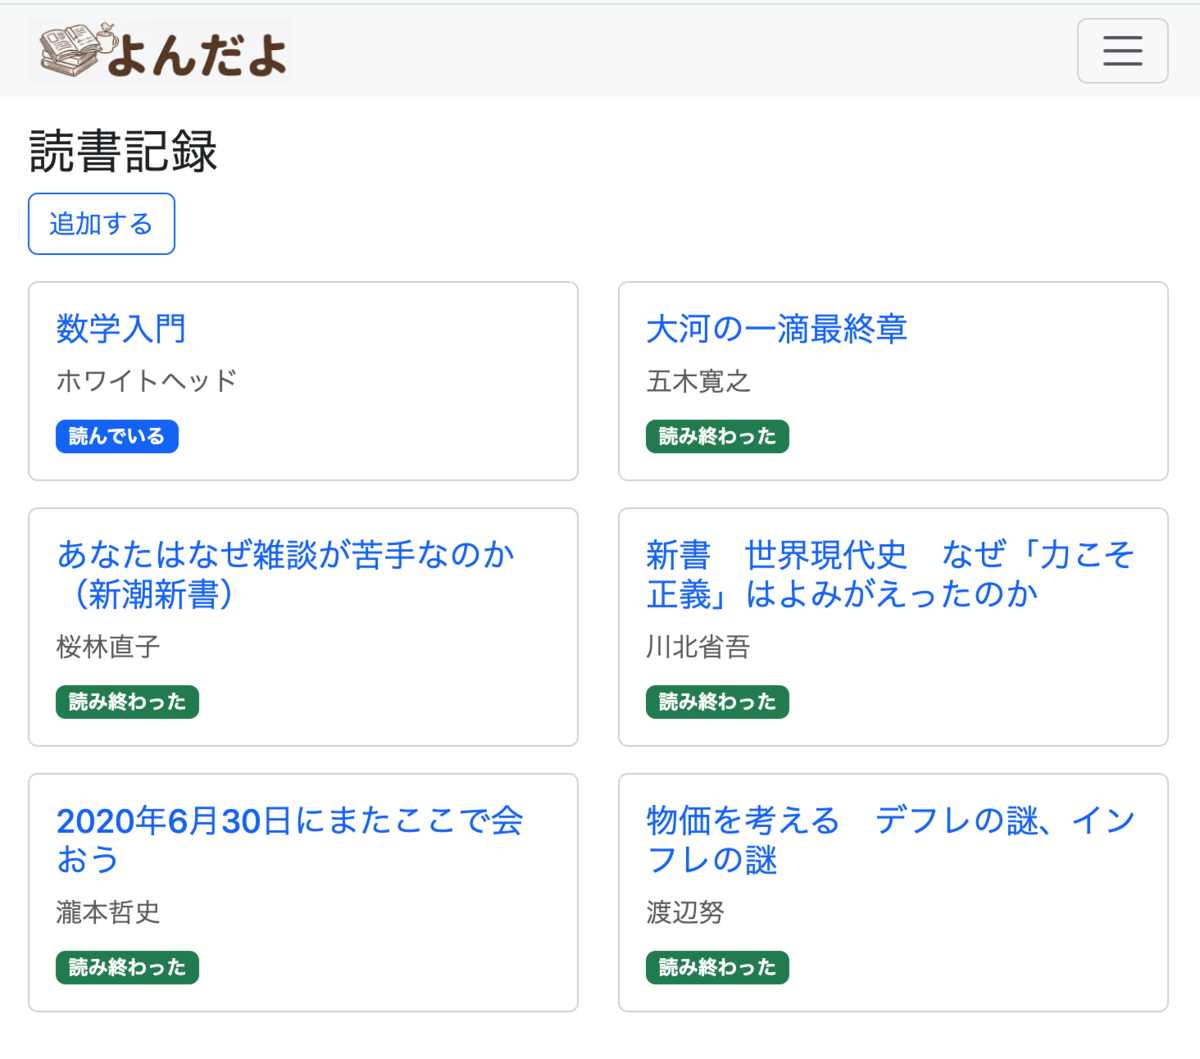
公開用のリンクは読書記録の詳細画面から取得できるようになっていて、ログインが必要な詳細画面とは分けて違う画面として用意した。
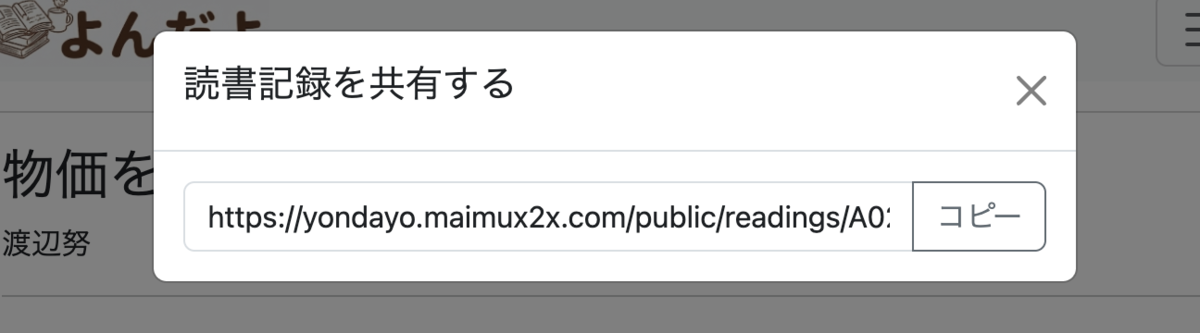
公開用のリンクからは書籍のタイトルと進捗状況、感想を見れるようになっている。
これだけではあるけど、デプロイした後も何気に使い続けていて、本の記録が増えてくる前に検索機能を追加しなきゃとかやっぱり書影を入れたい・・・とか改善したい部分がまだまだある。自分の趣味だったりに関係するちょっとしたお役立ちツールを自作するとちゃんと使うんだなということを実感している。
元々は書影を保存して表示させていたのだけれど、公開用のページを設けたり OGP を出す際に著作権的にグレーだなとなって、書影は保持しない形に修正して使っている。あったほうがリッチな感じにはなるんだけど、個人利用のアプリなのでなくても困らないという点でどうしようかな〜と迷い中。
作る過程でのあれやこれやは気が向いたら別のブログに書く!
このくらいのゆるさで作ったことだったり学んだことだったりの記録を気軽に続けていくぞ・・・!
RubyKaigi 2026 に参加した
函館で開催された RubyKaigi 2026 に参加してきました。
RubyKaigi 2023, 2025 に続いて3回目の参加でした。
今回は Day0 の移動日に風邪で体調を崩してしまいドリンクアップの類は全部キャンセル、観光は一切せず帰宅・・・という心残りな参加回になってしまいました。とはいえ、本編には参加することができ、RubyKaigi の現地の熱気を感じることができたのはとても良かったです。
本編では AI に関連する発表が増えていたり、Ruby Committers and the World でも AI を使うことについてで盛り上がっていましたが、私は RubyKaigi のトークの予習を Claude と一緒に取り組んで臨みました。Claude に自分が聞きたい発表の詳細ページの URL を渡して、発表前に押さえておくと良い用語や関連資料・過去の発表動画などを整理してもらって可能な範囲で自分でも調べたり資料に目を通しておいた感じです。ZJIT 関連の発表はそれでも難しくて分からないことだらけでしたが、Claude にまとめてもらった内容や事前に読んだり聞いておいた資料のおかげでこれまで参加した RubyKaigi の中で一番自分の中に引っかかる部分を感じながら聞くことができたと実感しています。
今回聞いた発表はこちら。
Day1
- The Journey of Box Building - RubyKaigi 2026
- Back to the roots of date - RubyKaigi 2026
- Million-Agent Ruby: Ractor-Local GC in the Age of AI - RubyKaigi 2026
- Exploring RuboCop with MCP - RubyKaigi 2026
- Kingdom of the Machine: The Tale of Operators and Commands - RubyKaigi 2026
- The design and implementation of ZJIT & the next five years - RubyKaigi 2026
- Digits, Digits, and Digits - RubyKaigi 2026
Day2
- Twenty Years of JRuby - RubyKaigi 2026
- The AST Galaxy to the Virtual Machine Blues - RubyKaigi 2026
- Uzumibi: Reinventing mruby for the Edges - RubyKaigi 2026
- Require Hooks: Filling the Gap in Ruby's Extensibility - RubyKaigi 2026
- A Faster FFI - RubyKaigi 2026
- Chasing Real-Time Observability for CRuby - RubyKaigi 2026
- Whose Memory is it Anyway - RubyKaigi 2026
- The future of Ruby documentation - RubyKaigi 2026
Day3
- Ruby Committers and the World - RubyKaigi 2026
- Autoresearching Ruby Performance with LLMs - RubyKaigi 2026
- A Write Barrier Validating GC for Ruby - RubyKaigi 2026
- From Ruby 2 to 4: Updating a C extension for a Modern VM - RubyKaigi 2026
- HTML-Aware ERB: The Path to Reactive Rendering - RubyKaigi 2026
- PicoRuby for IoT: Connecting to the Cloud with MQTT - RubyKaigi 2026
- Lightning-Fast Method Calls with Ruby 4.1 ZJIT - RubyKaigi 2026
- Matz Keynote - RubyKaigi 2026
今回は発表メインでたくさん聞きました! たくさん聞いたこともあって、個々の発表の感想は書ききれないのですが Oku Kazuho さんの 「Rapid Start: Faster Internet Connections, with Ruby's Help」、Vladimir Dementyev さんの「Require Hooks: Filling the Gap in Ruby's Extensibility」、Marco Roth さんの「HTML-Aware ERB: The Path to Reactive Rendering 」はもっと深ぼってみたい点や紹介されていたライブラリを試してみたかったり、特に印象に残った発表でした。
また、英語の発表を今年は積極的に聞きに行きました。昨年は英語の発表を聞くのは内容についていくことができずかなり厳しかったのですが、ゆるゆると英語の学習を1年続けた成果?と Claude との予習の効果もあってか、理解できる部分も増えていたのが嬉しかったです。一方で会話の方は全くダメだったので、次の1年は英会話にもちょっとだけ力を入れたい。一番力を入れたいのは プログラミングなので、英語はほどほどにやっていこうと思います。
最後に
まつもとゆきひろさんが AI を使って自分が欲しかったものをたくさん作って、実際に使って日々の生活で活用されていたり、spinel の開発についてを発表で聞いて、私もこれから1年間色々なものを作って試していきたいという気持ちが強くなっています。私はまだレベル感的に AI をバリバリ使いこなして何かを作るというより、自分で四苦八苦・試行錯誤しながら手を動かして開発したい気持ちの方が強いため、しばらくはその気持ちを大切にしつつ楽しく Ruby でプログラミングをしていきたいと思います!
発表者の皆様、オーガナイザー、スタッフの皆様、今年も素敵な RubyKaigi をありがとうございました! また、体調を気遣って声をかけてくれた Rubyist の方々も本当にありがとうございます。
RubyKaigi 2026 、体調や移動のトラブルなど色々なことがありましたが、参加することができて良かった!!
振り返ると良い1年だった
2025年は熱を出して寝込む回数が多かったり、自宅の鍵紛失未遂だったり、人見知りを拗らせまくったり、思い出すと色々あったのですが、それでも1年間たくさんの人と関われて、たくさんコードを書いて、いろいろな場所に出かけて・・・振り返ると充実した良い1年だったなと思います。
今年も1年、ありがとうございました!
トピックごとにざーっと振り返りをしようと思います。
カンファレンス参加
気がついたらたくさんのカンファレンスに参加していました。 2026年はどうなるかな。
- 東京Ruby会議 12
- TokyoWomen.rb
- RubyKaigi 2025
- 関西Ruby会議 08
- PicoRuby overflow
- Kaigi on Rails 2025
- VimConf small 2025
- TokyuRuby会議 16
- 北陸Ruby会議01
しんめ.rb
途中お休み期間をいただきましたが、12月に通算60回目まで開催を続けることができました。今年もたくさんの方が参加してくださり、ありがとうございました! 8月から開催を再開したのですが、開催頻度を減らしたのと Discord や esa を使うなどツールを見直してみたのが結果的には良かったです。
地域 Ruby 会議などに参加すると、しんめに参加してくださっている方と直接会える機会も多く、自分がせっせとカンファレンスに行く動機の一つになっていたりします。
登壇
TokyoWomen.rb で「Rails 1.0 のコードで学ぶ method_missing と find_by_* 」というタイトルで発表しました。 あと、LTだと TokyuRuby会議 16 で「Gentoo 1年生 ビルドは終わらない」というタイトルで発表しました。
Gentoo Linux を使い始める
2025年の一番大きな変化はこれだと思う。 Gentoo Linux を使い始めて、Web サービスを作るために Ruby や Rails を学んで成長したい!に1点集中だった自分の気持ちに新しい領域が加わりました。 ここはまだふわふわしていて具体的に表現できないのですが、OS や CLI 周りへの興味がとても強くなっています。Linux デスクトップを使うようになって、ターミナルや Zsh の設定も色々試して自分はどう使っていきたいのかを前よりも考えるようになりました。
仕事
一番頑張った。まだまだ自信はないし未熟者ですが、2025年に頑張ることとして挙げた「Webサービスの開発に必要な基礎体力を鍛える」は周りの方々にたくさん助けていただきながら概ね達成できたと思います。
私はPM出身で、良い Web サービスとは?みたいな問いがずっと自分の中にあるので、来年もこの問いを自分なりに突き詰めていきたい。今年は技術を身につければ良いサービスが作れるという自分の頭の片隅にあった思い込みをかち割ることができたので、「何を作るのか・なぜ作るのか」という部分もバランスをとりながら考えられるようになっていきたいと思っています。
趣味
推しのライブにたくさんいきました!生のパフォーマンスを観ることが自分にとって一番元気をもらえてリフレッシュできる時間なので、来年も可能な範囲で足を運びたい。 あとは、相変わらず陶芸でお皿とかマグカップを作ったり、エンジニアに転職して以降やっていなかったパン作りとかお菓子作りを再開することができました。
終わりに
早いものでエンジニアにキャリアチェンジして丸2年が経っていました。フィヨルドブートキャンプに通っていた頃を含めると早4年近くプログラミングに触れているわけですが、そこで費やしてきた時間に対して今の自分は成長が鈍化してないか・・・?みたいな不安が今年は強く、それが何となく自分の外側にも出てしまった1年だったなぁと思っています。
振り返ってみると自分なりに登壇や新しいことにトライして、技術面での課題も逃げそうになりながらも何とか踏ん張って向き合えたんじゃないか?!と思います。
来年はそんな自分を認めてもう少し自信を持っていきたい。
2026年もよろしくお願いします!
私の好きな Ruby の変数代入 Tips
「Ruby/Rails Advent Calendar 2025」の23日目の記事です!
先日、Ruby リリース30周年パーティに参加してきたのですが、歴代リリースマネージャの方の座談会、Ruby の未来の話など Ruby に関わるたくさんの方の話を伺うことができてとても充実した時間を過ごすことができました。
Ruby というプログラミング言語も、そのコミュニティも大好きな自分ですが、今回の記事では「私の好きな Ruby の変数代入 Tips」と題して、3つの方法に触れたいと思います。
partition で「意味のある2つ」に分ける
一つ目は Enumerable#partition メソッドです。
プログラムを書いていると、配列をある条件で2つに分けて扱いたくなることがよくありませんか。
partition は、ブロックで定義した条件の結果を2つの配列としてそのまま変数に受け取ることができる便利なメソッドです。
EC サイトのクーポンの有効期限を例に使い方を見てみたいと思います。
today = Date.new(2025, 12, 23) # Date.today だと日付が変動してしまうため、例として固定

coupons = [
  { code: 'COUPON_1', expires_on: Date.new(2025, 12, 10) },
  { code: 'COUPON_2', expires_on: Date.new(2025, 12, 25) },
  { code: 'COUPON_3', expires_on: Date.new(2025, 11, 15) },
  { code: 'COUPON_4', expires_on: Date.new(2026, 1, 1) }
]

active_coupons, expired_coupons = coupons.partition { it[:expires_on] >= today }

# expires_on は Date オブジェクトですが、分かりやすいように ISO 8601 形式で結果を載せています
pp active_coupons
# [{code: "COUPON_2", expires_on: "2025-12-25"},
# {code: "COUPON_4", expires_on: "2026-01-01"}]

pp expired_coupons
# [{code: "COUPON_1", expires_on: "2025-12-10"},
# {code: "COUPON_3", expires_on: "2025-11-15"}]
こんな感じで「何を基準に分けているのか」がコードから自然に読み取れるところが好きです。
values_at でハッシュや配列から必要な値だけを受け取る
2つ目は Hash#values_at です。
Rails の params から複数の値を取り出す際にとてもよく使います。
values_at は、引数で指定したキーに対応する値の配列を返します。そのため、分割代入を使って結果を個々の変数として受け取ることができます。
params = {variant: "りんご", origin: "青森県", producer: "Ruby 農園", price: 230}

variant, origin, price = params.values_at(:variant, :origin, :price)

variant #=> "りんご"
origin #=> "青森県"
price #=> 230
また、配列のインデックスを指定して値を取り出せるため、分割代入で不要な値を _ のように書かずに済みます。
row = ["001", "maimu", "maimu@example.com", "東京都", "03-1234-5678"]

id, name, tel = row.values_at(0, 1, 4)

id #=> "001"
name #=> "maimu"
tel #=> "03-1234-5678"
パターンマッチで右代入風に値を取り出す
3つ目はパターンマッチの => を使って右代入風に値を取り出す方法です。
この記事では、変数代入の Tips としてパターンマッチを紹介しています。パターンマッチ自体は代入に限らず、条件分岐などでも使える汎用的な機能です。
Ruby/Rails Advent Calendar 2025の17日目の記事で sanfrecce_osaka もパターンマッチについて書かれています!
そもそも、右代入とは?右代入風とは?という点についてまず触れたいと思います。
hash = { foo: 1, bar: 2, baz: 3 }
このようなハッシュがあって、一つ目の値を変数に入れたいとします。 普通に書くとこうなると思います。
foo = hash[:foo]

foo #=> 1
これをパターンマッチの => を使って書き換えることができます。
hash = { foo: 1, bar: 2, baz: 3 }

hash => { foo: }

foo #=> 1
右代入のイメージが持てたでしょうか? 次に「右代入風」と書いていることについてです。上の例のように見た目は「右代入」のように使えるのですが、内部的にはパターンマッチの照合が行われています。そのため、マッチしない場合は例外が発生します。代入ではなくマッチングであるため、「右代入風」と表現しています。
hash = { foo: 1, bar: 2, baz: 3 }

hash => { piyo: }
#  {foo: 1, bar: 2, baz: 3}: key not found: :piyo (NoMatchingPatternKeyError)
パターンマッチではなく通常の代入を使うと例外ではなく、値が nil になります。
piyo = hash[:piyo]

piyo #=> nil
パターンマッチによる代入はハッシュのネストが深くなった時により便利さを実感できます。
user = {
  name: 'Alice',
  profile: {
    age: 10,
    address: 'Wonderland'
  }
}
パターンマッチを使わない場合はこうですね。
address = user[:profile][:address]

address #=> 'Wonderland'
パターンマッチを使う場合は以下のように書くことができます。
user => { name:, profile: { address: } }

address #=>  'Wonderland'
初めて見ると一瞬「なんだこれは・・・?」と思ってしまいそうですが、動きがわかると普段の実装にも活用できるシーンは色々ありそうです。 私はパターンマッチを使うことで期待している構造を前提にシンプルにコードを書ける点が気に入っています。
まとめ
私の好きな Ruby の変数代入 Tips として、partition 、values_at、パターンマッチの => を使う方法について書いてみました。
何をしたいかやデータの構造に応じて使い分けて、これからもたくさん Ruby でプログラムを実装していきたいと思います!
